Escolher uma inteligência artificial pelo nome mais conhecido é tentador. O problema é que uma ferramenta capaz de escrever um ótimo texto pode não ser a mais eficiente para analisar um documento, corrigir código ou pesquisar informações recentes na internet.
Para observar e descobrir essas diferenças na prática, usamos o plano Safe do AllPass e enviamos as mesmas solicitações ao GPT-5.6 Sol, Gemini 3.1 Pro, Claude Sonnet 5 e Grok 4.6. A comparação incluiu seis tarefas próximas de situações reais: redação, análise de ficha técnica, tomada de decisão, correção de vulnerabilidades em código, revisão de texto e pesquisa na web.
O objetivo não foi montar um ranking definitivo. Modelos de IA mudam, respostas podem variar entre execuções e até a interface interfere na experiência. A pergunta mais útil, portanto, não é “qual é a melhor IA?”, mas “qual delas funcionou melhor para cada tipo de tarefa neste teste?”.
Este artigo também não é um review do AllPass. O foco está na vantagem prática de alternar entre diferentes famílias de modelos no mesmo serviço, inclusive quando uma delas encontra uma limitação no meio do trabalho.
Leia também: HostGator AllPass: como funciona, preços e testes com diferentes IAs (Review)
Por que comparar modelos dentro do AllPass?
Serviços oficiais de IA costumam apresentar seus próprios modelos como solução para muitas necessidades. Na rotina, porém, as diferenças aparecem em aspectos que não cabem em uma lista de recursos: obediência às instruções, qualidade da escrita, precisão na leitura de arquivos, profundidade do raciocínio, velocidade e facilidade para conferir fontes, são critérios fundamentais e que podem variar bastante de um modelo de IA para outro.
O AllPass reúne modelos da OpenAI, Google, Anthropic e xAI. No painel usado durante os testes, o GPT-5.6 Sol e o Claude Sonnet 5 apareciam entre os modelos Premium, enquanto o Gemini 3.1 Pro e o Grok 4.6 estavam na categoria de modelos Inteligentes. Essa classificação é relevante para o controle de uso da plataforma, mas não deve ser interpretada como um ranking automático de qualidade.
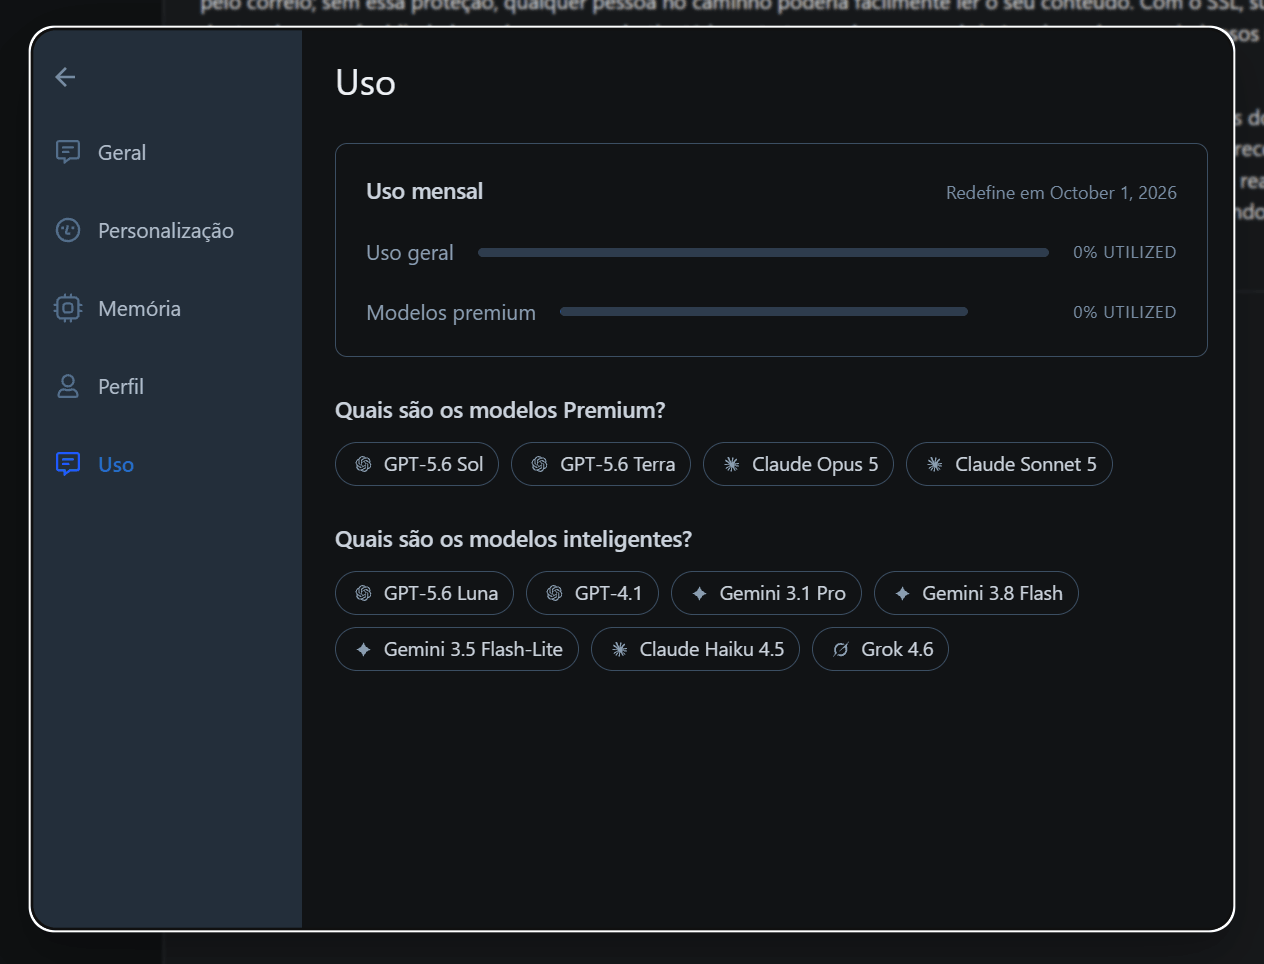
Ter várias opções no mesmo ambiente permite começar uma tarefa com o modelo que parece mais adequado e trocar de ferramenta se a resposta for lenta, superficial ou incapaz de processar determinado arquivo. Foi justamente essa flexibilidade que alguns testes evidenciaram.
Como realizamos o comparativo
Cada modelo recebeu a mesma solicitação e, quando necessário, os mesmos arquivos. Abrimos conversas separadas, registramos o tempo até a resposta terminar e avaliamos critérios definidos antes da comparação: cumprimento das instruções, precisão, clareza, utilidade prática e necessidade de correções.
Os tempos devem ser lidos como registros desta experiência, não como benchmarks definitivos. Eles podem variar de acordo com a carga do serviço, o tamanho da resposta e o uso de raciocínio ou pesquisa. Ainda assim, a repetição de certos padrões ao longo de seis tarefas ajuda a formar uma impressão útil.
Confira a seguir a bateria de testes realizada e os resultados de cada rodada.
Teste 1: Redação com regras detalhadas
No primeiro teste, solicitamos a introdução de um artigo sobre os riscos de escolher uma hospedagem de sites considerando apenas o preço. O texto deveria ter de 250 a 300 palavras, usar linguagem simples e natural, abordar desempenho, suporte, segurança e capacidade de crescimento, evitar clichês e terminar preparando o leitor para uma comparação entre tipos de hospedagem.
Os quatro modelos produziram textos aproveitáveis e cobriram os pontos centrais. As diferenças ficaram principalmente no estilo. O Claude apresentou uma redação natural, bem encadeada e adequada ao público iniciante. O GPT foi direto e organizado, com bom controle das restrições. O Gemini adotou um tom mais caloroso e recorreu a uma analogia para tornar a explicação acessível. O Grok foi claro, embora mais previsível e visivelmente mais lento.
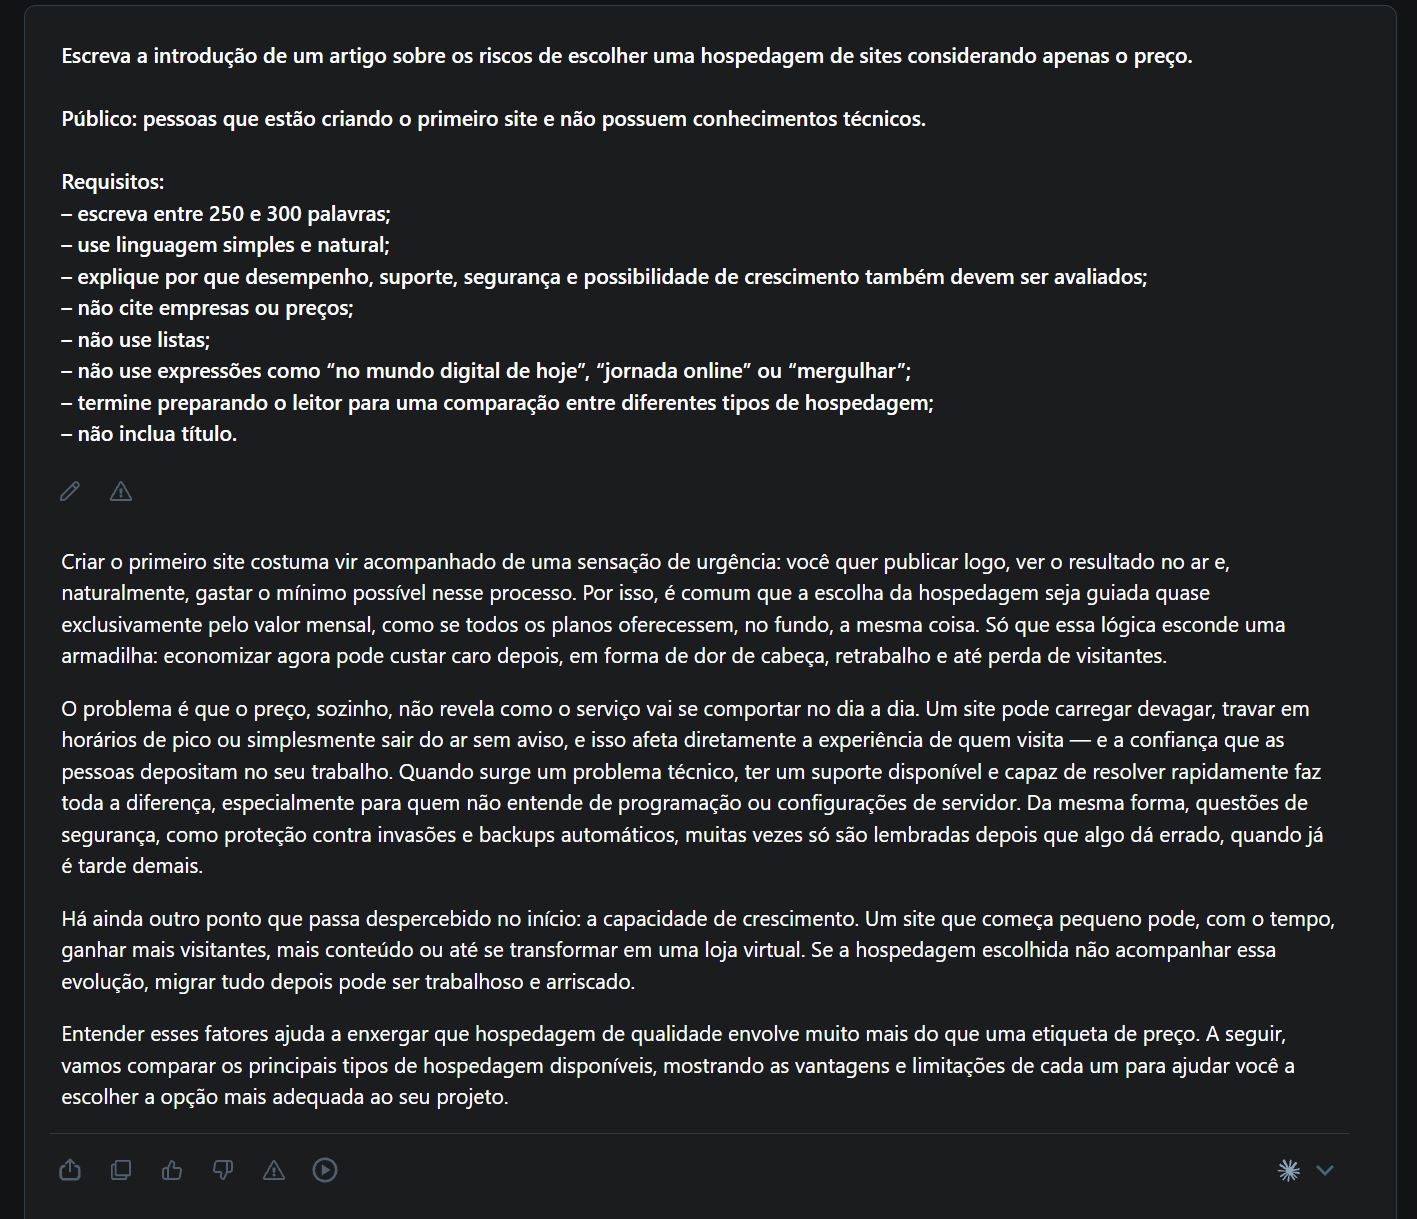
Gemini e Claude terminaram primeiro, o GPT levou alguns segundos a mais e o Grok demorou cerca de um minuto. Para redação editorial, o Claude teve uma pequena vantagem pela naturalidade, mas não houve uma distância grande o bastante para descartar os demais.
Melhor escolha nesta tarefa: Claude para um primeiro rascunho mais natural; GPT para quem prioriza controle e objetividade.
Teste 2: Leitura e análise de uma ficha técnica em PDF
No segundo teste, para aproximar a comparação de uma situação real, anexamos a ficha técnica de um carro da BYD. O arquivo continha seis páginas e o modelo do veículo é o BYD Dolphin Special Edition. O prompt enviado para todas as IAs continha um pedido para resumir o documento, montar uma tabela de especificações com indicação de página, identificar recursos de segurança, apontar informações ausentes para uma decisão de compra e registrar ambiguidades sem consultar fontes externas.
Todos os modelos extraíram corretamente os principais dados do veículo, como dimensões, distância entre-eixos, peso, porta-malas, potência, torque, aceleração, velocidade máxima, autonomia, carregamento, central multimídia e garantias. Também perceberam dois pontos que mereciam conferência: a capacidade da bateria aparecia em kW, quando normalmente se espera kWh, e uma terceira fileira tinha saídas de ar apesar de a lotação indicada ser de cinco lugares.
A diferença mais significativa surgiu na referência às páginas. O Claude considerou a capa como a primeira página e apontou os dados nas páginas 2 a 6 do PDF. GPT, Gemini e Grok numeraram apenas as cinco páginas de conteúdo. Para quem precisa conferir rapidamente uma informação no arquivo original, especialmente se o mesmo conter muitas páginas, essa precisão pode fazer diferença.
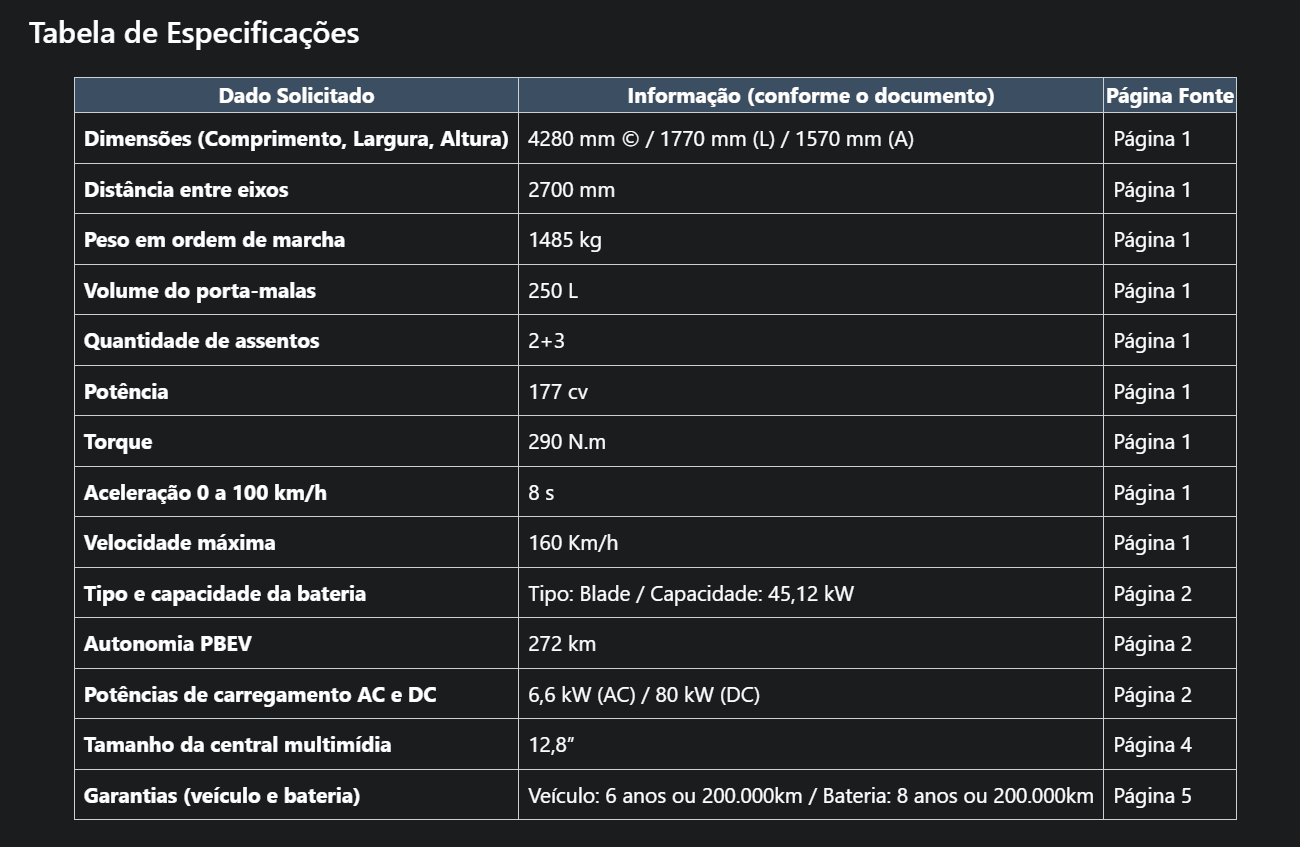
O GPT foi o mais minucioso ao separar ambiguidades, lacunas e limitações da verificação. O Gemini foi o mais rápido e ainda entregou uma leitura sólida. O Claude demorou um pouco mais, mas teve a melhor atribuição de páginas. O Grok produziu uma resposta útil, porém levou 4 minutos e 10 segundos, o que é muito acima dos 35 segundos do Gemini, 45 segundos do GPT e 50 segundos do Claude, sem oferecer uma vantagem equivalente.
Melhor escolha nesta tarefa: Claude quando a localização exata no documento é decisiva; Gemini quando a prioridade é obter rapidamente uma síntese confiável.
Teste 3: Escolha de um plano de hospedagem
Neste teste, apresentamos os dados dos planos Start, P, M e Turbo da HostGator e um cenário hipotético: uma pequena agência com três domínios, 35 GB ocupados hoje, previsão de chegar a 65 GB em 12 meses, 12 contas de e-mail e cerca de 40 mil visitas mensais, com picos de campanha. A tarefa era recomendar o plano de menor custo que atendesse às necessidades, sem pesquisar na internet.
Nessa rodada, houve consenso: os quatro modelos recomendaram o plano M. Todos eliminaram Start e P por aceitarem apenas um domínio, observaram que os 100 GB acomodariam a projeção de 65 GB e reconheceram que as contas de e-mail ilimitadas atenderiam às 12 contas previstas. O Turbo oferecia recursos adicionais, mas não era a opção de menor custo capaz de cumprir o cenário.
O GPT apresentou o raciocínio mais verificável. Calculou a ocupação atual de 35%, a futura de 65% e a margem restante de 35 GB, além de separar requisitos objetivos de fatores que não podiam ser concluídos somente com o número de visitas. Claude e Gemini chegaram à mesma recomendação com boa clareza; o Claude foi mais contido, enquanto o Gemini usou uma linguagem um pouco mais promocional. O Grok foi cuidadoso, mas novamente demorou mais.
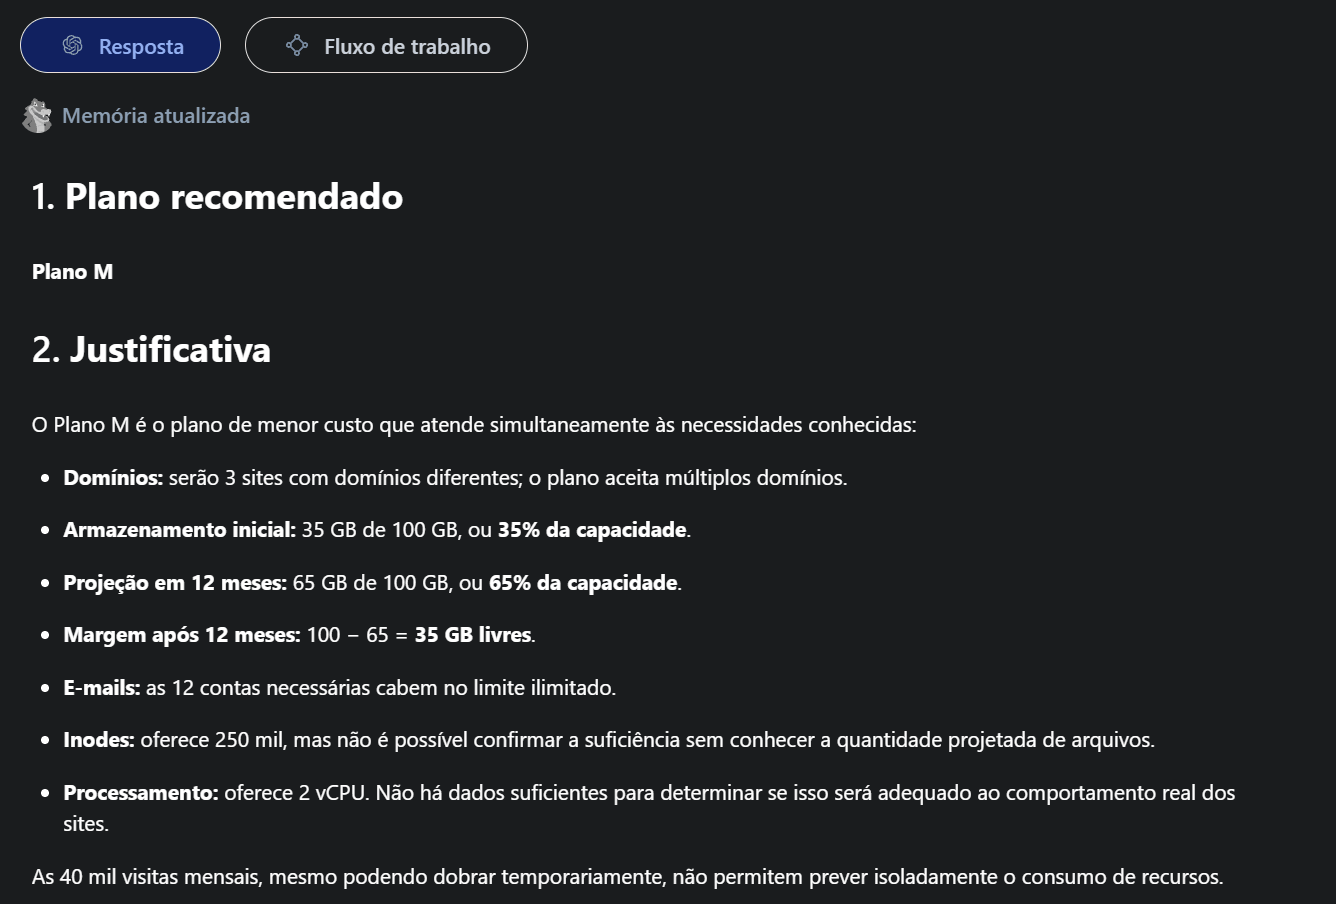
Os tempos foram de 12 segundos para o GPT, 18 para o Claude, 29 para o Gemini e 1 minuto e 15 segundos para o Grok. Todos fizeram ainda uma ressalva correta: visitas mensais, isoladamente, não revelam consumo de CPU e memória. Erros de recursos, lentidão ou picos persistentes seriam sinais para reavaliar o plano.
Melhor escolha nesta tarefa: GPT, pela combinação de velocidade, cálculo explícito e separação clara entre fatos e incertezas.
Teste 4: Diagnóstico de vulnerabilidades em um projeto React
Aqui, usei um projeto pessoal, que não está em produção, salvo no GitHub em um repositório público, criado com Vite e React. Eu recebi alguns alertas avisando que o projeto continha algumas vulnerabilidades que precisavam ser corrigidas. Como o projeto não está em produção, não fiz nenhuma correção. No entanto, me pareceu uma ótima oportunidade para comparar as habilidades de código dos 4 modelos de IA em teste.
O GitHub mostrava cinco alertas relacionados ao pacote js-yaml. Anexei os arquivos package.json e package-lock.json do projeto e pedi para cada uma das IAs identificar de onde vinha a dependência, propor a correção e explicar os riscos.
Após a análise, o GPT chegou à solução mais consistente: o js-yaml 4.1.0 era uma dependência transitiva de desenvolvimento, trazida pela cadeia eslint → @eslint/eslintrc → js-yaml. A atualização do lockfile para a versão 4.3.2 corrigiria quatro dos cinco alertas sem exigir mudança direta no package.json. Um alerta permaneceria porque a correção correspondente existia apenas na linha 5.x.
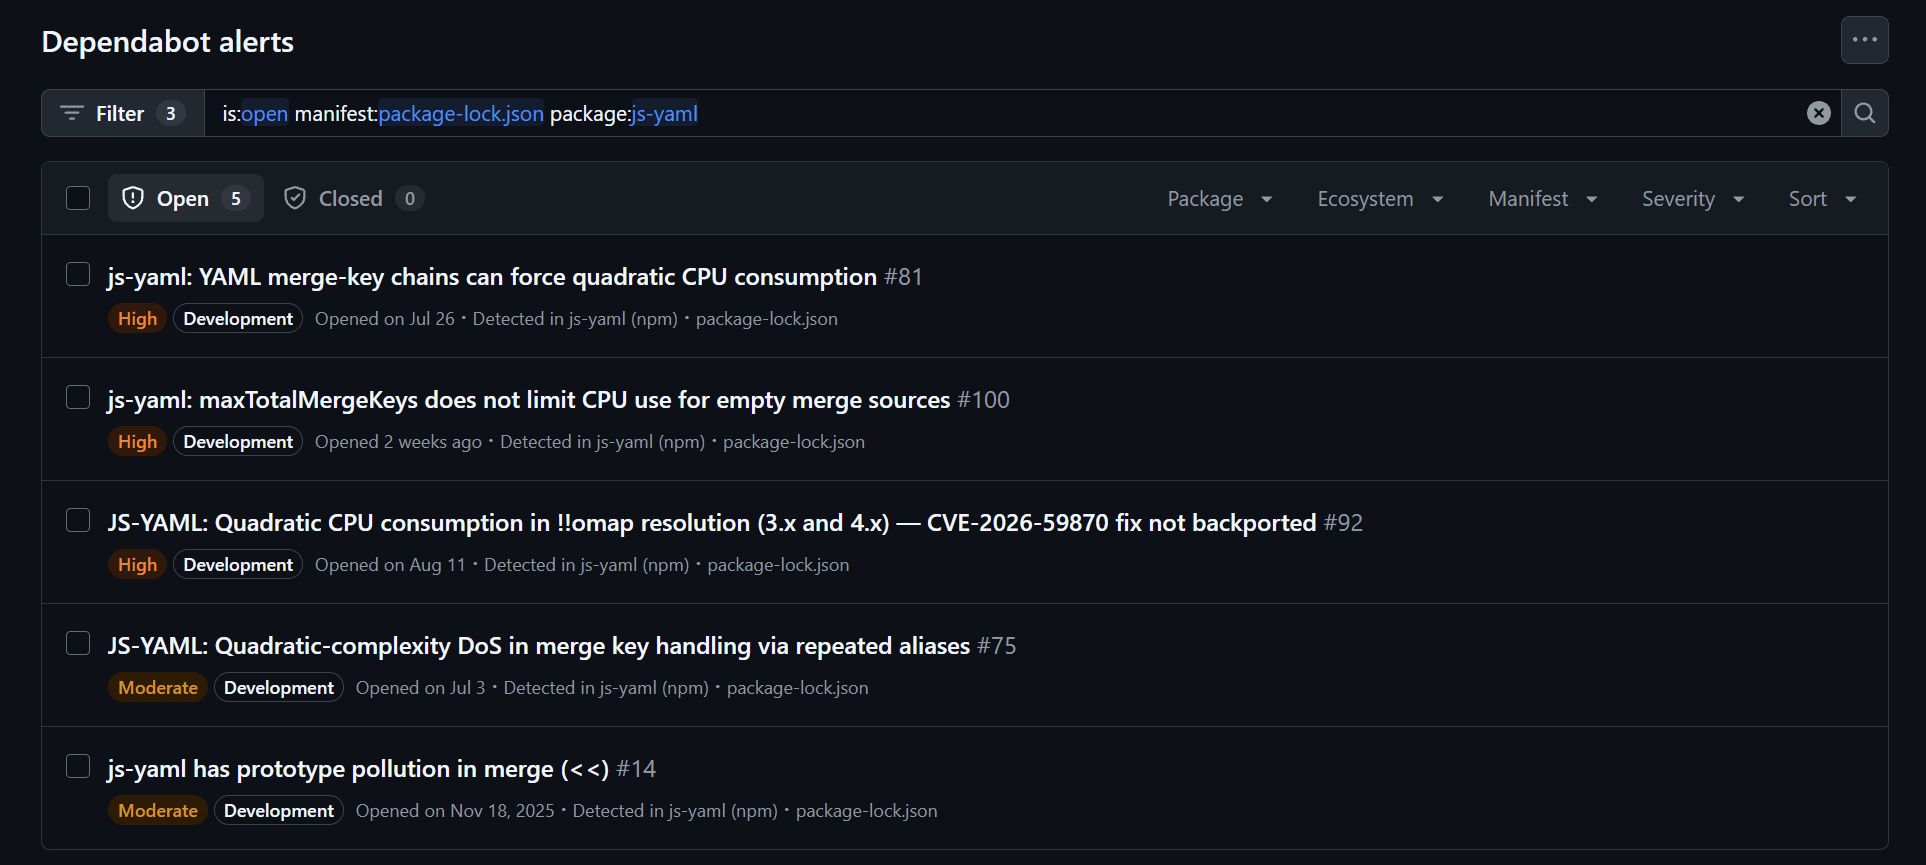
O modelo também explicou por que não seria prudente forçar uma versão principal incompatível apenas para zerar o painel. Como a aplicação não está em produção e não recebe YAML de usuários, fazia mais sentido aplicar a atualização compatível, documentar o risco residual e acompanhar a dependência pai.
O Claude também chegou a uma análise forte, mas encontrou uma limitação: não conseguiu ler o package-lock.json em nenhuma das tentativas, mesmo após reiniciar a sessão, apagar a memória e renomear o arquivo. Para concluir, foi necessário colar trechos do código na conversa. O Gemini reconheceu que parte da análise do arquivo era inferida, e sua sugestão de instalação direta poderia alterar o package.json apesar de defender uma correção mínima. O Grok propôs adicionar overrides, uma intervenção mais ampla do que a necessária.
Esse teste revelou algo que rankings de resposta raramente mostram: a melhor ferramenta também precisa funcionar com os arquivos do fluxo real. Quando um modelo não lê um anexo, poder trocar imediatamente para outro é uma vantagem tão concreta quanto a qualidade do texto gerado.
Melhor escolha nesta tarefa: GPT-5.6 Sol, por confirmar a cadeia de dependências e propor a correção mais conservadora e verificável.
Teste 5: Revisão de um texto promocional
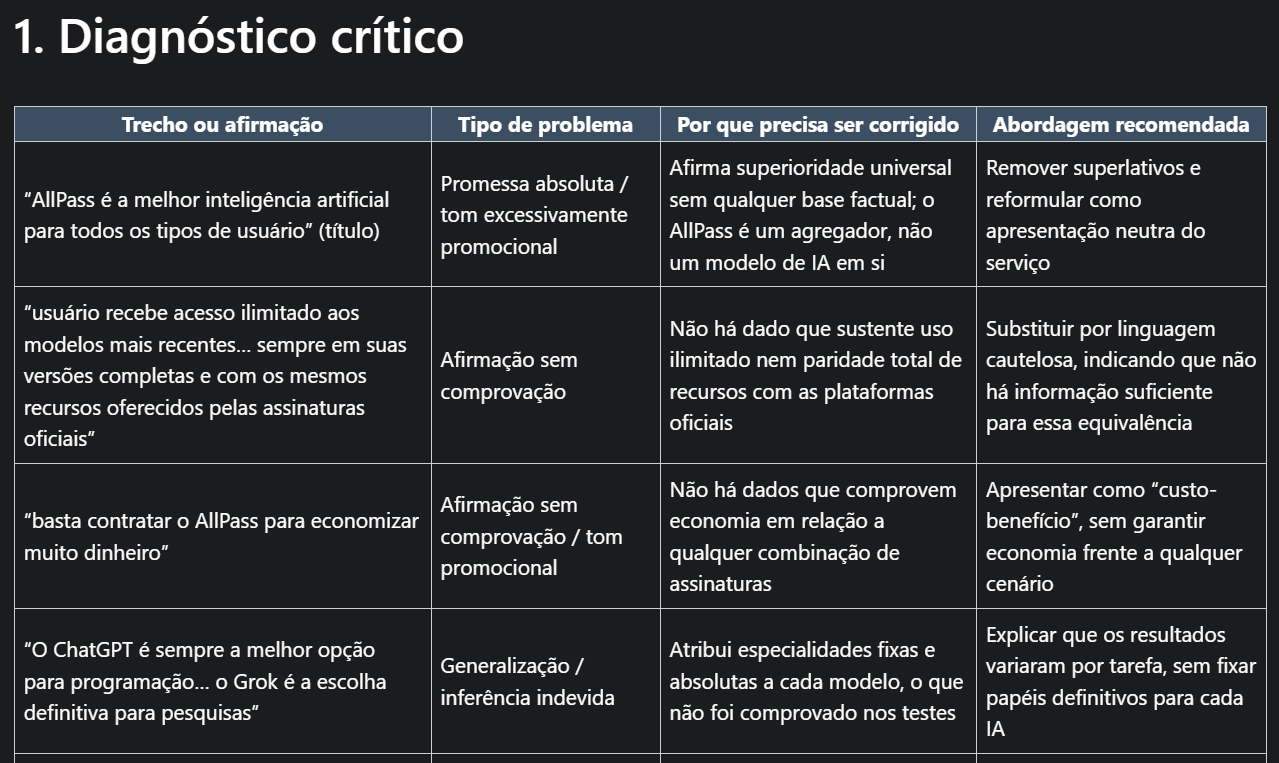
Neste teste, com ajuda da IA, criamos um texto promocional para divulgar o AllPass com exageros e afirmações sem comprovação: promessa de uso ilimitado, equivalência total aos serviços oficiais, superioridade absoluta de modelos Premium, produtividade dez vezes maior, confiabilidade de 100% e garantias sobre privacidade. Os modelos deveriam identificar os problemas, reescrever o texto em tom editorial e explicar as melhorias.
Os quatro modelos reconheceram os principais riscos e entregaram versões mais responsáveis. Removeram absolutos, evitaram atribuir especialidades fixas aos modelos, separaram observações dos testes de promessas gerais e transformaram a chamada comercial em uma conclusão mais informativa.
GPT e Claude foram os mais rigorosos. O GPT produziu a versão mais contida e reforçou que políticas de privacidade e treinamento precisam ser verificadas nos termos do serviço. O Claude apresentou uma crítica editorial abrangente e bem organizada. O Gemini escreveu com clareza, embora de forma um pouco mais genérica. O Grok também cumpriu a tarefa, mas levou quase quatro minutos sem entregar uma vantagem proporcional.
Os tempos ficaram próximos entre GPT, Gemini e Claude: 52 segundos, 56 segundos e 1 minuto, respectivamente. O Grok demorou 3 minutos e 52 segundos.
Melhor escolha nesta tarefa: empate técnico entre GPT, pela cautela factual, e Claude, pela qualidade da revisão editorial.
Teste 6: Pesquisa sobre um produto recém-lançado
Na última etapa, pedi explicitamente para as IAs pesquisarem na internet e fazer uma comparação entre o iPhone 18 Pro e iPhone 17 Pro. A resposta deveria separar fatos oficiais, resultados de testes independentes e interpretações, considerar preço e disponibilidade no Brasil, citar fontes e alertar que informações sobre o iPhone 18 convencional ainda não foram divulgadas oficialmente.
Esse foi o teste em que quantidade e qualidade de fontes mais se afastaram. O GPT apresentou 109 referências na interface, o Grok 110, o Claude 40 e o Gemini 16. GPT, Claude e Grok também montaram coleções de imagens, algo que não foi pedido. Como as imagens não haviam sido solicitadas, a ausência não contou como falha, e parte das imagens trazidas pelos modelos era pouco relevante.
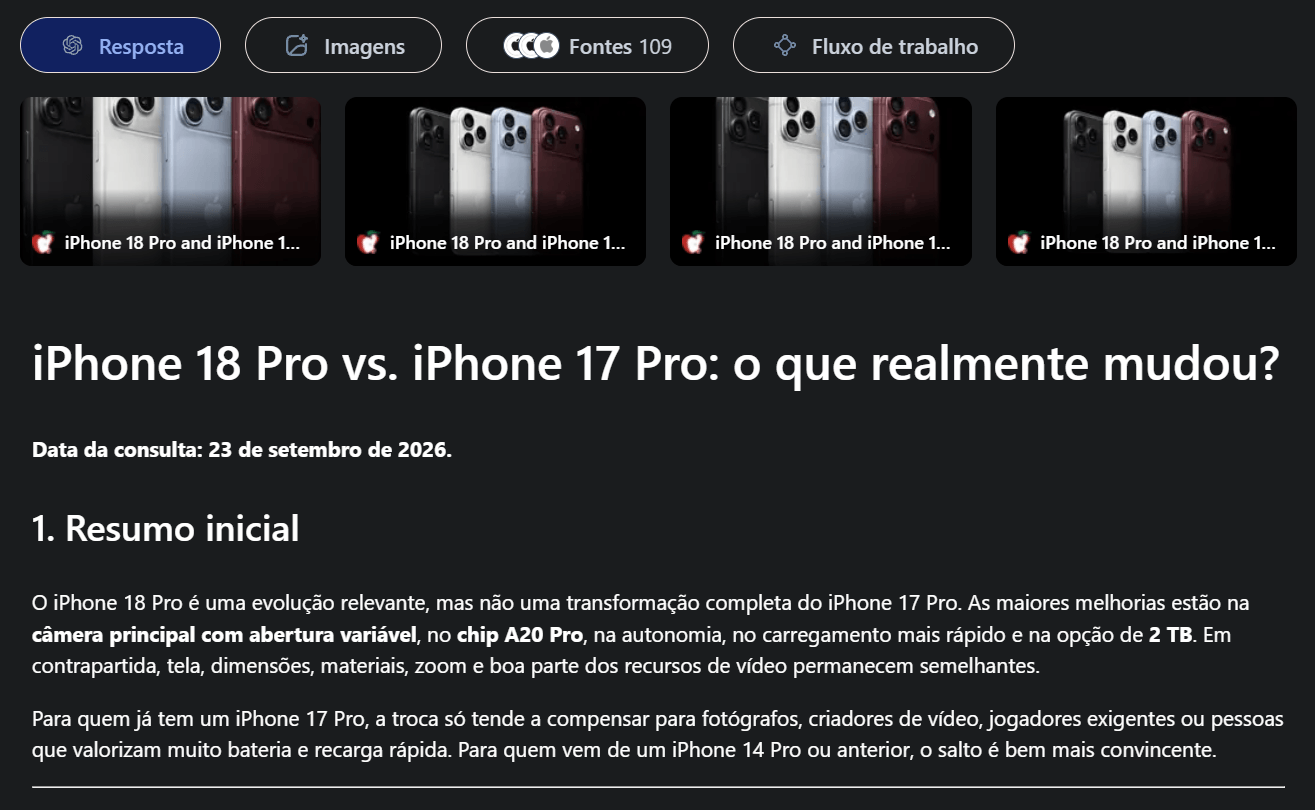
O GPT entregou o melhor equilíbrio entre cobertura, precisão e separação de evidências. O Grok pesquisou com amplitude e trouxe observações úteis sobre preços, mas incluiu alguns números incorretos e expôs trechos do processo de pesquisa na resposta. O Gemini foi o mais conciso e relativamente rápido, porém usou poucos testes independentes e cometeu uma imprecisão sobre o carregamento. O Claude foi o mais rápido, mas apresentou erros em preço inicial, autonomia de bateria e interpretação de resultados, além de depender mais de notícias de lançamento do que de avaliações independentes.
Nenhum modelo cumpriu perfeitamente o limite de 900 a 1.200 palavras. O Gemini ficou mais próximo, enquanto o Grok ultrapassou com folga. A principal lição foi simples: dezenas de links não garantem uma resposta correta. É preciso verificar se as fontes sustentam exatamente as afirmações feitas e se dados oficiais, testes e rumores estão devidamente separados.
Os tempos foram de 1 minuto e 10 segundos para o Claude, 1 minuto e 18 segundos para o Gemini, 1 minuto e 50 segundos para o GPT e 2 minutos e 6 segundos para o Grok.
Melhor escolha nesta tarefa: GPT para uma pesquisa mais criteriosa; Gemini 3.1 Pro para obter uma visão inicial com mais rapidez, desde que os números importantes sejam conferidos.
Qual IA foi melhor para cada tarefa?
Diante dos resultados, não é possível afirmar que um modelo será sempre superior. Eles mostram, contudo, tendências úteis dentro desta bateria de testes:
- Redação natural: Claude Sonnet 5 apresentou o texto mais fluido, enquanto o GPT-5.6 Sol se destacou pelo controle das instruções.
- Leitura de documentos: Claude Sonnet 5 foi mais preciso nas páginas; Gemini 3.1 Pro combinou boa extração com maior velocidade.
- Raciocínio e tomada de decisão: GPT-5.6 Sol tornou os cálculos e as incertezas mais fáceis de auditar.
- Código e segurança: GPT-5.6 Sol propôs a correção mais conservadora e confirmou melhor a cadeia de dependências.
- Revisão e reescrita de texto: GPT-5.6 Sol e Claude Sonnet 5 foram os mais rigorosos na remoção de exageros.
- Pesquisa na internet: GPT-5.6 Sol apresentou o melhor equilíbrio entre fontes e precisão; Gemini 3.1 Pro foi uma alternativa mais rápida para a primeira leitura.
- Exploração ampla: Grok 4.6 entregou respostas detalhadas e utilizáveis, mas foi o mais lento em todos os testes com tempos registrados e não obteve uma vantagem clara de precisão.
Em outras palavras, GPT foi o mais consistente nas tarefas analíticas, Claude brilhou mais em escrita e leitura cuidadosa de documentos, Gemini ofereceu boa velocidade em várias situações e Grok mostrou amplitude, embora com um custo maior de tempo nesta experiência.
Velocidade: qual modelo respondeu mais rápido?
Considerando apenas os cinco testes com cronometragem exata para todos os modelos, os resultados foram:
Claude e Gemini apareceram com frequência entre os mais rápidos. O GPT não ficou muito distante e venceu o teste de tomada de decisão. Já o Grok foi consistentemente o mais demorado, às vezes por vários minutos. Isso não significa que o modelo seja sempre lento, mas a repetição do padrão é relevante para quem usa IA muitas vezes ao longo do dia.
Quanto os testes consumiram do plano Safe?
O painel de uso permaneceu em 0% após as primeiras solicitações curtas. Depois do teste com a ficha técnica, o uso geral chegou a 1%, enquanto o marcador de modelos Premium continuava em 0%. Ao final de todos os testes, incluindo PDFs, arquivos de código, textos longos e pesquisa na web, o painel mostrava 3% de uso geral e 2% de uso de modelos Premium.
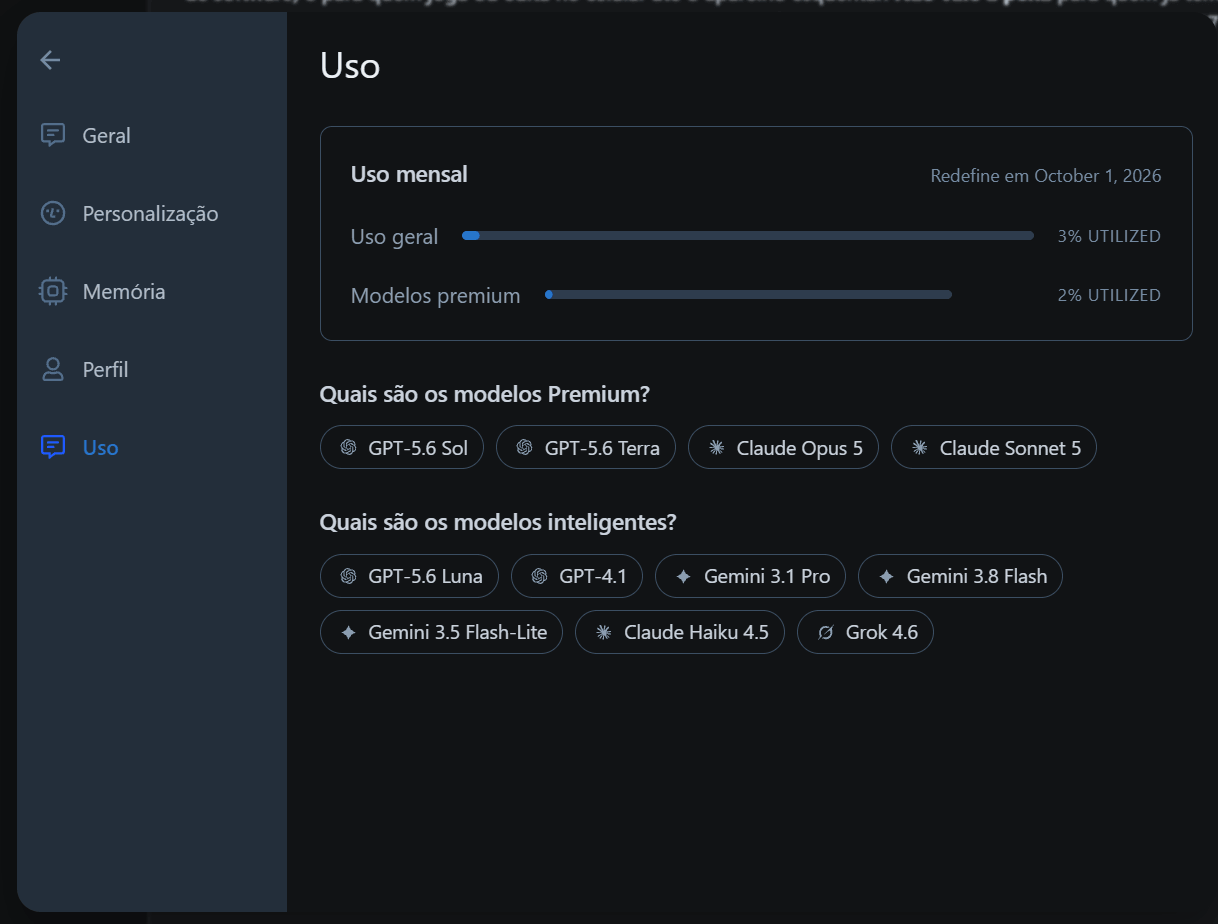
Não é possível saber exatamente o quanto cada modelo consumiu em cada tarefa. No entanto, os limites parecem ser bastante generosos. Eu usei o plano Safe, do AllPass, mas acredito que não exista diferença, no aspecto do consumo, com relação ao plano Entry. As diferenças entre os dois planos estão mais relacionadas à mecanismos de proteção para dados sensíveis do que o uso de tokens disponíveis.
Vale a pena ter vários modelos no mesmo lugar?
Acredito que a principal vantagem foi poder escolher a ferramenta de acordo com o trabalho e mudar de modelo quando necessário. O Claude escreveu muito bem, mas falhou ao abrir um arquivo importante no teste de código. O Gemini foi rápido na ficha técnica, mas menos profundo na pesquisa. O GPT foi o mais consistente em análise, embora nem sempre fosse o primeiro a responder. O Grok ofereceu respostas detalhadas, mas exigiu mais espera.
Esse comportamento reforça a proposta de valor do AllPass. Em vez de manter várias assinaturas apenas para alternar entre fornecedores, o usuário pode experimentar diferentes modelos dentro do mesmo serviço. O baixo consumo observado no plano Safe torna esse acesso especialmente interessante para quem mistura tarefas no dia a dia, como redação, estudo, análise de arquivos, programação e pesquisa, sem depender de uma única IA.
Conclusão: não existe uma melhor IA para tudo
Depois de seis testes, a resposta para a pergunta do título é menos simples do que seria construir um ranking. O Claude Sonnet 5 se destacou na escrita natural e na referência a documentos. O Gemini 3.1 Pro foi ágil e competente em tarefas de leitura e síntese. O GPT-5.6 Sol apresentou o desempenho mais consistente em raciocínio, código, revisão factual e pesquisa. O Grok 4.6 entregou conteúdo utilizável e amplo, mas foi o mais lento nesta bateria.
Nenhuma dessas conclusões, no entanto, pode ser considerada definitiva. Os modelos de IA são atualizados com frequência, as respostas variam e uma solicitação bem formulada pode mudar bastante o resultado. Por isso, a melhor estratégia talvez seja combinar ferramenta, tarefa e nível de verificação necessário.
É justamente aí que o AllPass faz bastante sentido. Ele não elimina a necessidade de revisar respostas, mas facilita comparar abordagens e escolher a que atende melhor a cada momento. Em vez de perguntar qual IA merece ocupar sozinha o primeiro lugar, o usuário pode manter diferentes especialistas ao alcance e usar cada um onde ele demonstrar mais valor.
Para conhecer mais detalhes, acesse o site do HostGator AllPass.